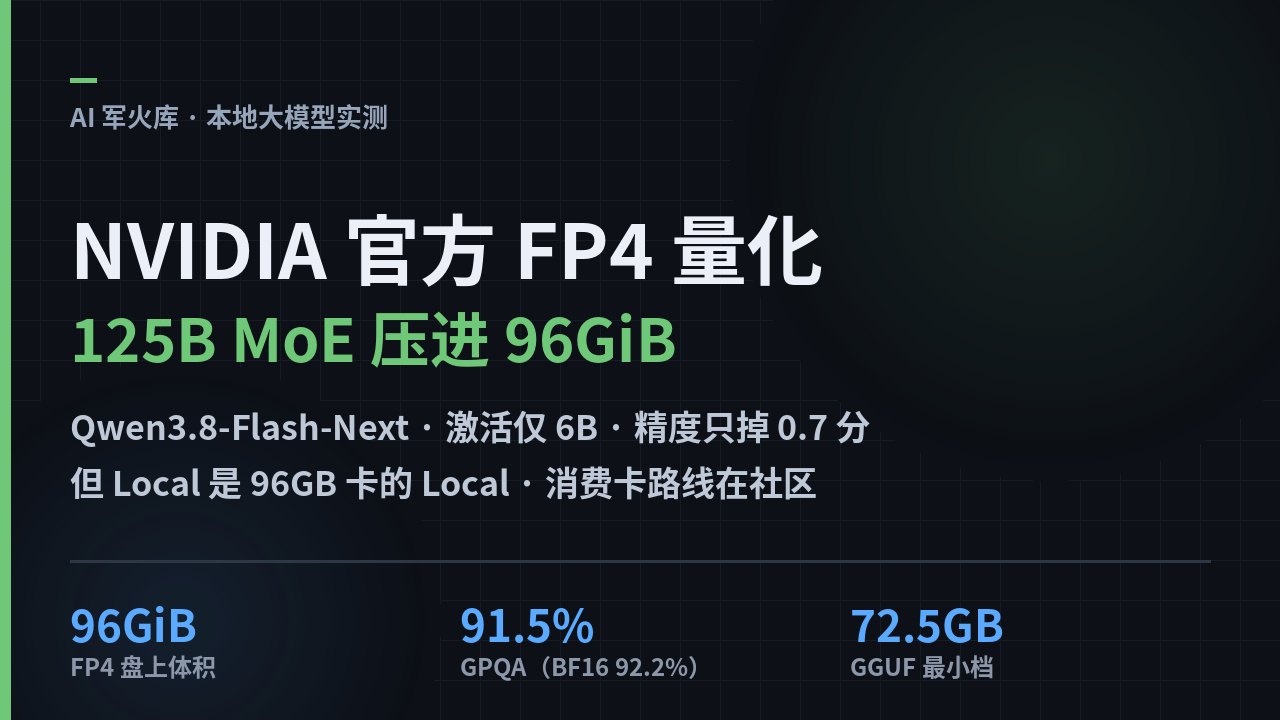
NVIDIA 官方把 125B 的 Qwen3.8-Flash-Next 压到 96GiB,精度只掉 0.7 个点——但先别急着下载:这个"Local"是 96GB 显存的 RTX PRO 6000 和 128GB 的 DGX Spark 的"Local",不是 32GB 显卡的"Local"。消费卡玩家的路线在社区量化那边。这篇把官方版的真实门槛、精度数据、和你手里 24-32GB 卡能走的替代路线一次讲清。
一、先说结论
- Qwen3.8-Flash-Next:阿里开源的混合注意力 MoE——总参 125B、激活仅 6B,外加 51B n-gram 嵌入表(PLE)和 4B MTP 模块,512 专家取 10,支持 262K 上下文,带视觉编码器
- NVIDIA FP4-Local(10-08 发布,10-15 更新):官方 Model Optimizer + QAD(量化感知蒸馏)做的 NVFP4 量化,盘上约 96GiB,GPQA Diamond 91.5%(BF16 是 92.2%),工具调用 88.7%(BF16 89.4%)——精度损失确实小
- 但官方验证硬件只有两个:RTX PRO 6000 Blackwell(96GB)单卡、DGX Spark(128GB 统一内存)。32GB 以下的卡跑不了这个 checkpoint
- 消费卡路线看社区:Strata 打包版(NVFP4-GPTQ,下载 14.5 万)和 GGUF 全家桶(最小的 IQ1_S 档也要 72.5GB 盘上体积),这才是 24-32GB 显存 + 大内存玩家能碰的
- 还有个坑:FP4-Local 的 scale factor 用了新无损压缩格式,上游 vLLM 还没支持,必须用 NVIDIA 给的社区容器
二、环境硬件条件
官方版 FP4-Local 的门槛(官方 README 口径):
| 项目 | 要求 |
|---|---|
| 权重体积 | 约 96GiB(21 个 5GB 分片) |
| 验证硬件 | RTX PRO 6000 Blackwell 单卡(需 PLE offload,850K token FP8 KV);DGX Spark(可 1M token KV) |
| 推理引擎 | vLLM 社区容器(eugr/spark-vllm-b12x 等),上游 vLLM 暂不支持其 scale 格式 |
| 许可 | NVIDIA Open Model Agreement + 底座 Qwen Community License 1.0,可商用 |
消费卡替代路线的条件(社区口径):
| 路线 | 盘上体积 | 大致门槛 |
|---|---|---|
| GGUF IQ1_S | 约 72.5GB | 24GB 显存 + 96GB 级内存 offload,纯显存装不下 |
| GGUF Q2_K_XL | 约 78.9GB | 32GB 显存 + 大内存 offload |
| Strata NVFP4-GPTQ | dense 6GB + experts 68GB + PLE 51GB | 靠 Strata 引擎按需加载专家,吃内存不吃显存,96GB+ 内存起步 |
注意 PLE 那张 51B 的 n-gram 嵌入表是体积大户(FP8 也要 51GB),所有"能不能跑"的问题最后都变成"这张表放哪"——官方答案是 offload 到内存,Strata 的答案是分片按需读。
三、实测数据(官方口径 + 本站未实测声明)
官方精度对比(README 表格原值):
| 精度 | GPQA Diamond | ToolEvalBench |
|---|---|---|
| BF16 | 92.2% | 89.4% |
| FP4-Local | 91.5% | 88.7% |
GPQA 掉 0.7 个点、工具调用掉 0.7 个点,对 4bit 级量化来说是很干净的结果——QAD 蒸馏(BF16 教师给 token 概率+隐状态目标,2500+1500 步训练)确实比直接量化狠。
量化细节(哪些层没被压): 解码器路由专家 NVFP4(E2M1 值 + E4M3 block scale)、注意力 MXFP8、视觉 MLP NVFP4、归一化层保 BF16/FP32 原字节。也就是说 NVIDIA 没一刀切,注意力这种对精度敏感的留了高位宽。
本站未做 FP4-Local 实测(96GiB 权重超本站单卡),上表全部为官方 README 数据;社区 GGUF/Strata 的 tok/s 属单源口径,本文不引用冒充实测。
四、踩坑指南(针对想上官方 FP4-Local 的人)
- 看到"Local"就下载——96GiB 下完才发现单卡装不下,白等几小时。先核自己显存+内存总量再动手
- 拿上游 vLLM 直接起——scale factor 新压缩格式不支持,起不来不是环境问题。README 明说要等上游合并,现在只能用指定容器
- 忘了 PLE offload 参数——RTX PRO 6000 单卡 96GB 也塞不下全部,官方命令里 PLE offload 是跑通的前提,照抄命令别删参数
- 许可证混为一谈——量化版走 NVIDIA Open Model Agreement,底座走 Qwen Community License 1.0,商用合规两个都要看
五、避坑指南
- 32GB 卡别硬凑官方版:等上游 vLLM 支持 + 更小的官方蒸馏版,现在强跑 GGUF 低比特版体验不如等
- IQ1_S 是"能跑"不是"好用":1bit 级量化在 125B 上损失明显,社区口径写代码/推理质量掉得多,当尝鲜可以,当生产力选 Q2_K_XL 以上
- 内存比显存更先成为瓶颈:51GB 的 PLE 表 + MoE 专家卸载,96GB 内存是地板不是起点,想舒服上 128GB
- A 卡玩家:官方容器全是 CUDA 路线;ROCm 侧走 Strata/GGUF 社区包,本站 AMD 路线实测在排期中,出了会单独发文
- 激活只有 6B 不等于快:MoE 的速度命门在专家权重的读取带宽,内存带宽 40GB/s 级别的 DDR4 平台会明显拖后腿,这是平台问题不是模型问题
六、配置清单(照抄档)
| 你的硬件 | 建议 |
|---|---|
| RTX PRO 6000 / DGX Spark | 官方 FP4-Local + 指定 vLLM 容器,照 README 命令跑,别改参数 |
| 32GB 显存 + 96GB+ 内存 | GGUF Q2_K_XL(78.9GB)或 Strata NVFP4-GPTQ 包,靠 offload 换容量 |
| 24GB 显存 + 96GB 内存 | GGUF IQ1_S(72.5GB)尝鲜,1bit 档质量损失大,生产力慎选 |
| 内存不足 96GB | 别碰这个 125B,27B 稠密档(Qwen3.8-27B Q4)仍是甜点位 |
数据源:nvidia/Qwen3.8-Flash-Next-FP4-Local 官方 README(2026-10-15 更新,精度表/硬件验证/量化细节均为原文);Qwen/Qwen3.8-Flash-Next config.json(架构参数为文件读回值);GGUF/Strata 体积为 HuggingFace API 读回值(2026-10-22)。精度为官方口径非本站实测;社区量化质量与速度为单源口径,待复现。