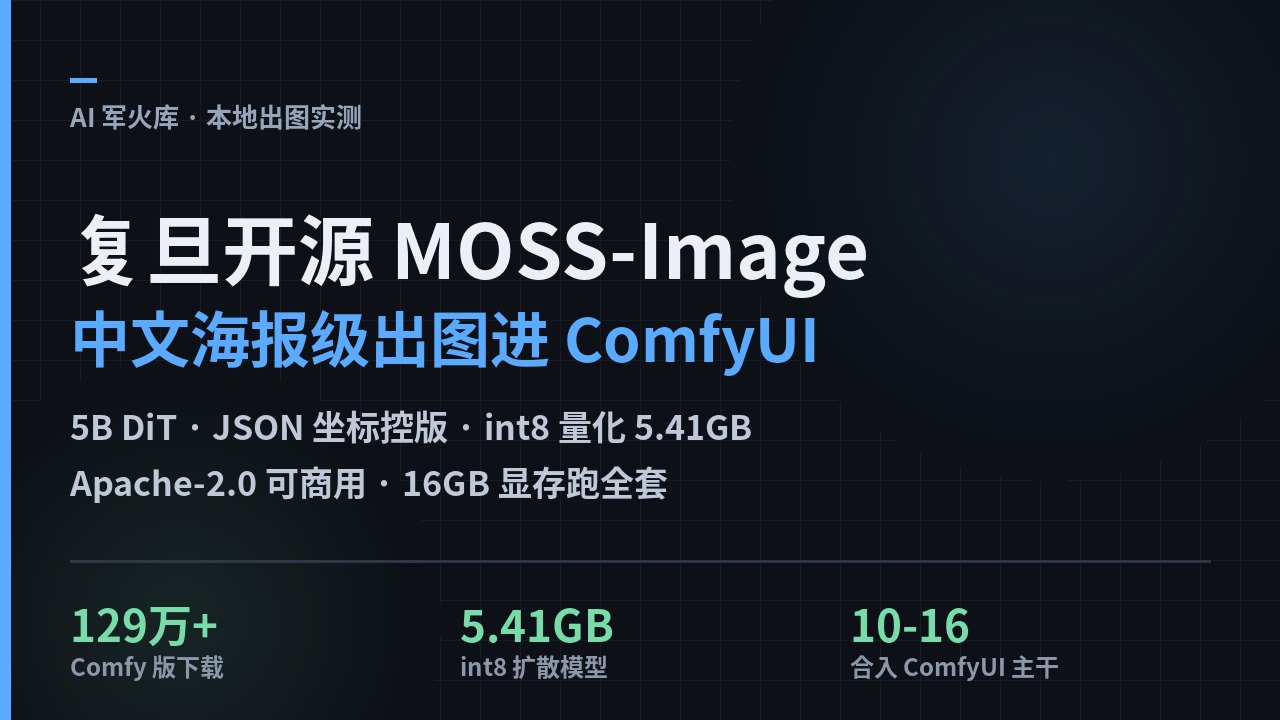
复旦 OpenMOSS 团队把"写中文不乱码"做进了模型架构:5B 单流 DiT、JSON 坐标框控排版、Apache-2.0 直接商用。ComfyUI 官方支持 10 月 16 日已合入主干,int8 量化版扩散模型只有 5.41GB——16GB 显存的卡就能跑全套。这篇把文件怎么选、工作流怎么搭、哪些坑官方文档里已经写明但没人整理,一次讲完。
一、先说结论
- MOSS-Image 是复旦 OpenMOSS 发布的开源文生图模型,5B 参数单流 DiT,主打中文文字渲染 + Layout 坐标控版,适合海报、图文卡片、电商主图这类"图里必须有字"的场景
- 许可证 Apache-2.0,商用无 AGPL 那种传染义务,比 FLUX.2 的 dev 许可干净
- ComfyUI 原生支持已于 2026-10-16 合入官方仓库(PR #17095),但 v0.41.3 正式版还没带上,要用 master/nightly 或官方插件
- 量化路线齐全:官方 Comfy-Org 仓库有 int8_convrot 版扩散模型(5.41GB)+ W4A8-GPTQ 文本编码器(7.34GB),社区还有 8 步/4 步蒸馏版
- 本站核过 HF 官方仓库文件清单和官方文档,显存占用为按文件体积推算的估算值,非实测,口径见文末
二、环境硬件条件
官方 README 给的最低要求(NVIDIA 口径):
| 项目 | 要求 |
|---|---|
| GPU | NVIDIA CUDA 卡;Python 路线要 PyTorch 2.9+ |
| Python | 3.10+ |
| ComfyUI | master/nightly(含 commit e087d8f6 之后),或装官方 moss-image 插件 |
| 依赖 | diffusers≥0.38、transformers≥5.3、accelerate≥1.10(Python 路线) |
A 卡(ROCm)玩家:官方只写 NVIDIA。ComfyUI 本身在 ROCm 上跑得通 FLUX 系(同为 DiT + 单文件加载),MOSS-Image 走的是标准 Load Diffusion Model + CLIP Loader 路线,理论上 ZLUDA/ROCm 版 ComfyUI 可尝试,但官方未验证,翻车概率不低,属"待复现",别当承诺看。
按文件体积推算的显存档位(估算值,按权重体积 + FLUX 同类经验推算,非实测):
| 档位 | 组合 | 推算依据 |
|---|---|---|
| 32GB+ | bf16 全家桶(DiT 10.16GB + TE 19.31GB + VAE 0.34GB) | 文件合计约 30GB,需 offload 或 48GB 更稳 |
| 16GB | int8 DiT(5.41GB)+ W4A8 TE(7.34GB)+ small VAE(0.25GB) | 合计约 13GB,配合 --lowvram 顺序加载可进 16GB |
| 12GB | int8 DiT + W4A8 TE + 文本编码器 offload 到内存 | 靠 ComfyUI 卸载机制,速度换容量,待复现 |
三、模型文件怎么选(HF 实测文件清单)
官方 ComfyUI 格式仓库 Comfy-Org/MOSS-Image(10-20 更新,下载量已破 129 万),文件体积为 HF API 读回的真实值:
| 文件 | 体积 | 放哪 |
|---|---|---|
| moss_image_sft_bf16.safetensors | 10.16GB | models/diffusion_models/ |
| moss_image_sft_int8_convrot.safetensors | 5.41GB | models/diffusion_models/ |
| moss_image_base_bf16 / int8 | 10.16 / 5.41GB | 同上(Base 版) |
| qwen3.5_9b_bf16.safetensors | 19.31GB | models/text_encoders/ |
| qwen3.5_9b_int8_convrot.safetensors | 9.75GB | models/text_encoders/ |
| qwen3.5_9b_w4a8_gptq.safetensors | 7.34GB | models/text_encoders/ |
| flux2-vae.safetensors / flux2-vae_small | 0.34 / 0.25GB | models/vae/ |
| moss_image_color_depth_control.safetensors | 0.31GB | models/loras/(控制 LoRA) |
Base 还是 SFT? Base 是没做后训练的底模,保留完整训练信息,方便社区练 LoRA;SFT 是监督微调版,文字分组和版面更整齐。做海报/图文直接上 SFT;要练自己的 LoRA 才下 Base。 两个都别下错——Base 直接出图文字排版会散。
国内下载走 hf-mirror.com 或 ModelScope(openmoss 空间同名)。
四、ComfyUI 部署步骤(原生路线)
- 升级 ComfyUI 到含 MOSS-Image 支持的 master/nightly(10-16 合入,PR #17095),并重装当前
requirements.txt依赖 - 按上表放好三类文件:扩散模型、文本编码器、VAE
- 节点用三个标准加载器:Load Diffusion Model + CLIP Loader(type 选
moss_image) + Load VAE - 官方示例工作流在仓库
comfyui/moss-image/example_workflows/moss-image.json,拖进去即可 - 出图设置(官方推荐默认):Euler / 50 步 / CFG 3 / Shift 5 / 负分支第 22 层跳过(SLG),1024×1024 起步
不想升 master 的,装 ComfyUI Manager 搜 MOSS-Image 装官方插件,走 HF 目录加载器(model_path 指向含 transformer/text_encoder/tokenizer/vae 的本地目录)。
分辨率规则:官方推荐 1M~2M 总像素,可外推 512×512(0.25M)到 2K(4M);手动输入宽高必须是 16 的正整数倍,否则直接报错。
五、踩坑指南(官方文档写明但容易忽略的)
- v0.41.3 正式版没有原生支持——官方文档 10-19 明确写了这一点。装了"最新版"ComfyUI 找不到
moss_image类型不是你的问题,换 nightly 或走插件 - 插件工作流和原生工作流不能混用——只换模型加载器不够,要整条换原生工作流。原因:原生模型的 timestep multiplier 不同
- ModelSamplingSD3 节点不能照搬——插件工作流里的这个节点拿到原生路线会出坏图,原生调 shift 用 ModelSamplingAuraFlow(multiplier 1)
- TorchCompileModel 会吃掉 SLG/层跳过——要用 SLG 或改 block patches 就得 eager 执行,别图快开编译
- 文本编码上限 4096 token——超长提示词会被截断,别把整篇文案塞进提示词
六、避坑指南
- 别把 int8 版当"效果打折":int8_convrot 是官方自己出的量化,不是第三方魔改;社区另有 lodestones 的 8 步 DMD 蒸馏版(下载 6.8 万)和 4 步版,出图快但细节以社区口径为准,单源待复现
- 12GB 以下显存别硬上 bf16 文本编码器:19.31GB 的 qwen3.5_9b_bf16 单文件就超卡,直接选 w4a8_gptq(7.34GB)
- 商用看许可证:模型 Apache-2.0,可闭源集成、可商用;但社区 LoRA(如 NSFW 类)另看各自许可,别混
- 想要文字控制力:官方带一个 color_depth_control LoRA(0.31GB),Layout 用 JSON 绝对像素坐标(1024×1024 画布坐标范围 -512~+512),做电商主图排版的值得研究官方 USERGUIDE
七、配置清单(照抄档)
| 你的卡 | 扩散模型 | 文本编码器 | VAE | 备注 |
|---|---|---|---|---|
| 24GB+(3090/4090/R9700) | sft_bf16 | qwen3.5_9b_int8 | flux2-vae | 质量优先,TE 用 int8 省 10GB |
| 16GB(4060Ti16G/5060Ti16G) | sft_int8_convrot | qwen3.5_9b_w4a8_gptq | flux2-vae_small | 官方量化全家桶 |
| 12GB | sft_int8_convrot | qwen3.5_9b_w4a8_gptq | flux2-vae_small | 需 offload,速度换容量,待复现 |
| 练 LoRA | base_bf16 | qwen3.5_9b_bf16 | flux2-vae | Base 底模 + 大显存 |
这套流水线也可以直接封进 VideoFree 的 MCP 工作流,智能体调节点出图,本站后续会出封装教程。
数据源:MOSS-Image 官方 README / USERGUIDE_ZH / comfyui README(OpenMOSS/MOSS-Image,GitHub);Comfy-Org/MOSS-Image 文件体积为 HuggingFace API 读回值(2026-10-21);模型发布于 2026-10-11,技术报告 arXiv:2610.23374。显存档位为按文件体积推算的估算值,非本站实测;社区蒸馏版效果为单源口径,待复现。