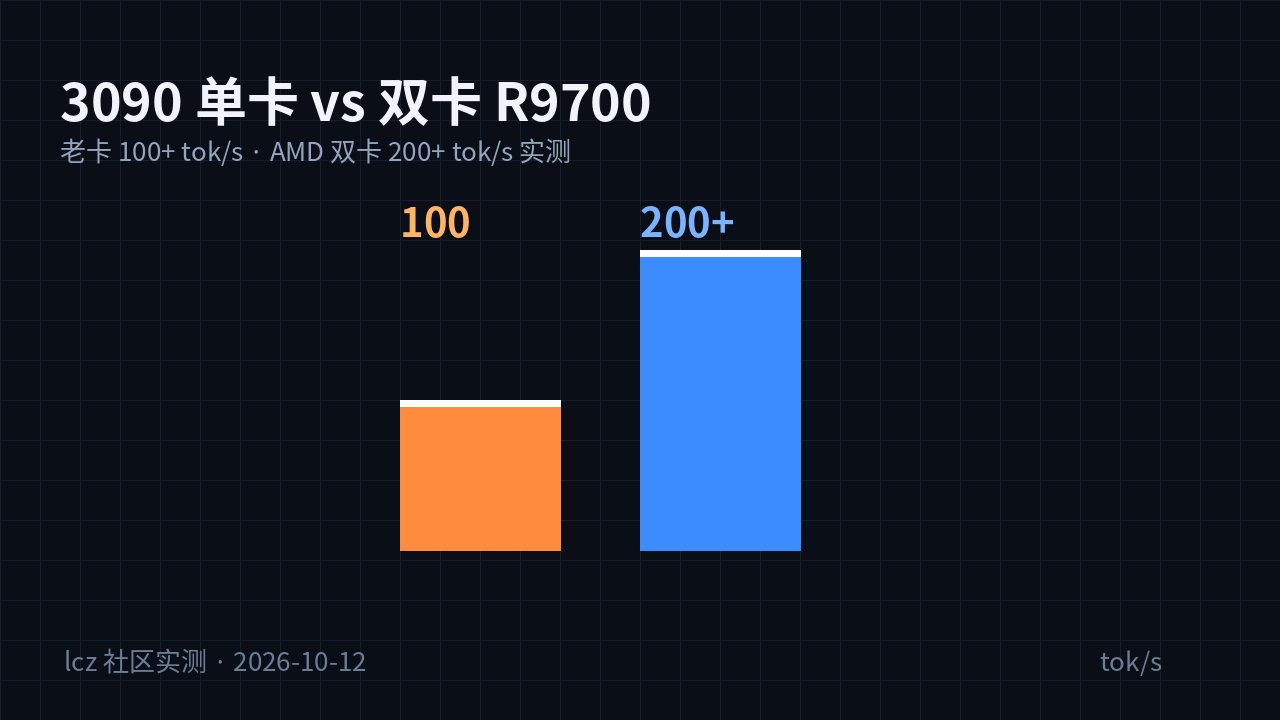
今天给你两组硬数字:一张 2022 年的老 3090,能跑出 Coding 破 100 tok/s;两张 AMD R9700 双卡组合,decode 直接站上 200+ tok/s。都不需要机房、不需要 N 卡最新旗舰——这是 lcz 社区最近 48 小时内的两组实测。
一、一张老 3090,跑 125B 级模型
先看这组数据(lcz 社区实测,10 月 11 日,约 27 小时前):
| 项目 | 数值 |
|---|---|
| 显卡 | 单张 RTX 3090(24G,2022 年发售) |
| 内存 | 64GB |
| 模型 | Qwen3.8 Flash Next(125B 级) |
| 量化 | IQ3_XXS(特优化量化,接近 Q4 无损) |
| 上下文 | 128K |
| Coding 速度 | >100 tok/s |
| Chat 速度 | >60 tok/s |
来源帖:https://lcz.me/topic/1988,另有 3080 的旁帖(https://lcz.me/topic/1987)交叉印证。
这组数字的重点不是"快",而是"卡有多老"。 3090 是 2022 年的 A 卡时代 NVIDIA 消费旗舰,现在闲鱼上两千多块就能收一张成色好的。用它跑 125B 级模型 + 128K 长上下文,Coding 场景破 100 tok/s——意味着长文档编程、代码库问答这类场景,响应速度已经接近"打字速度"的上限了。
关键在量化方案:IQ3_XXS 是针对这类模型特化的优化量化,精度接近 Q4,体积却压得更小——这是 24G 显存能塞下 125B 级模型 + 大上下文的唯一原因。
二、双卡 R9700:AMD 阵营的 decode 新标杆
第二组数据更"今天"——发帖于 10 月 12 日 05:30 UTC,不到 1 小时前的社区实测:
| 项目 | 数值 |
|---|---|
| 显卡 | 2 × AMD Radeon AI PRO R9700(32G,共 64G 显存) |
| 框架 | vLLM + Paiton 插件 |
| 模型 | Qwen3.8-Flash-Next |
| decode | >200 tok/s |
| prefill | >8000 tok/s |
来源帖:https://lcz.me/topic/2253,配套插件仓库:https://github.com/Eliovp-BV/paiton-vllm-plugin
解读这组数字:
- decode >200 tok/s 是什么概念?人阅读中文的速度约 6-8 tok/s,200+ tok/s 意味着输出速度是阅读速度的 25 倍以上——"生成完等它"永远轮不到你。
- prefill >8000 tok/s 决定的是"开场白有多快":扔给它一个 10 万 token 的长上下文,8 秒左右就能读完。
- AMD 32G GDDR6 的卡(R9700)+ vLLM 插件路线,正在变成本地大模型部署的一条正经主力路线,不再是"凑合能跑"。
三、两组数字放在一起看
把两张表并排:
| 3090 单卡 | R9700 双卡 | |
|---|---|---|
| 总显存 | 24G | 64G |
| 卡年代 | 2022 | 2026 在售 |
| 单流输出 | >100 tok/s | >200 tok/s |
| 成本量级 | ¥2-3k(二手) | ¥2w 级(双卡) |
结论(基于上面两组实测数据):
- 单卡场景,"老卡 + 特化量化"依然能打——3090 的性价比没有被新卡碾过去,128K 长上下文 + 100 tok/s 是实打实的可用线。
- 双卡 AMD 路线已经过了"能跑"的门槛,进入"比 N 卡快"的区间——decode 200+ tok/s 是社区实测数字,多卡同品牌 P2P 是这条路线成立的前提。
- 预算决策很简单:单流自用 + 预算 3 千 → 收二手 3090 走 Strata/量化路线;要 128K 大上下文 + 高并发 → 上双卡 64G 显存池。
四、想复现?先核对三件事
这些是社区单帖实测数据(非官方基准),复现前建议核对:
- 量化版本:IQ3_XXS 的权重文件必须对得上(不同量化文件速度差可达一倍),下载后核对哈希。
- 内核与驱动:AMD 路线要确认 ROCm 版本匹配(R9700 走 ROCm,N 卡走 CUDA),插件版本见仓库 release 页。
- 上下文长度:128K 和 8K 的速度不是同一个数字,表格里的数字对应的是 128K 长上下文工况。
原始帖子(可自行查看完整配置与命令):
- 3090 单卡:https://lcz.me/topic/1988
- 3080 旁证:https://lcz.me/topic/1987
- 双 R9700:https://lcz.me/topic/2253
- Paiton vLLM 插件:https://github.com/Eliovp-BV/paiton-vllm-plugin